

01 认识 Kilo Code:一个能在项目里行动的开源编程 Agent
Kilo Code 是一款采用 MIT 许可证的开源编程 Agent,可运行在 VS Code、Cursor、Windsurf、JetBrains、CLI 和云端等环境中。 与普通聊天式 AI 不同,它能直接进入项目现场:读取文件、分析依赖、制定方案、修改代码、执行命令,并根据测试结果继续调整。Ask、Plan、Code、Debug 和 Custom 等模式,分别适合代码问答、方案设计、功能实现、问题排查及自定义工作流。 在 OpenRouter 的热门 APP 调用量排行榜上,Kilo Code 高居第五位,每周的 Token 调用量超过 5T。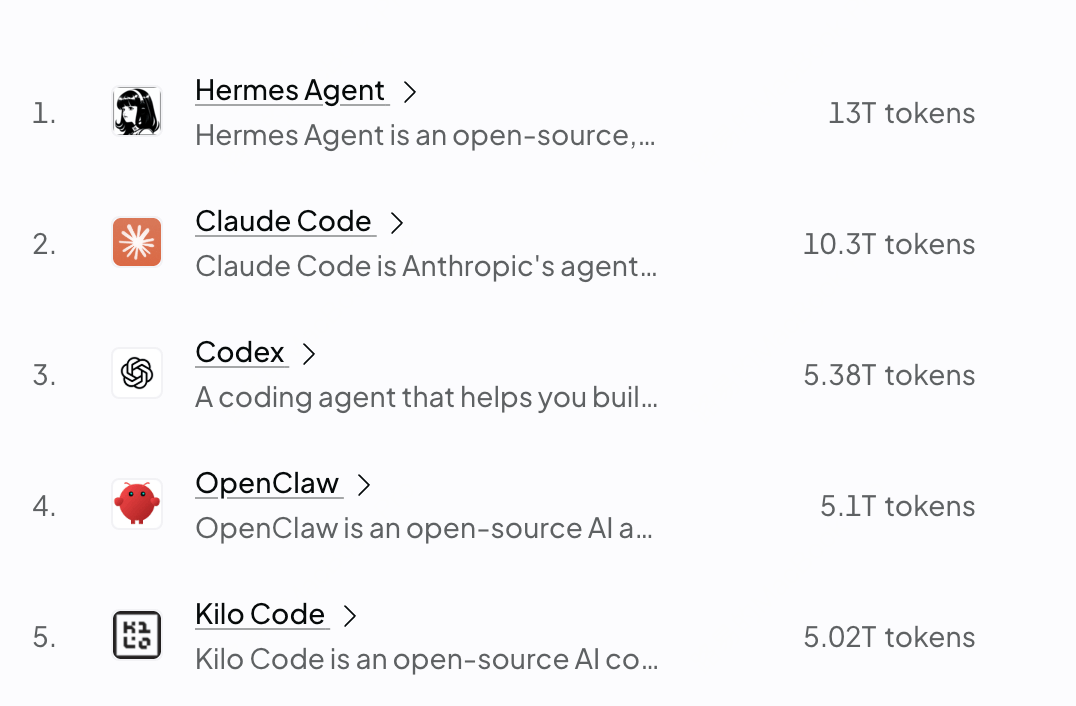
02 简单三步,在 Kilo Code 中接入 PPIO
Kilo Code 支持 OpenAI 兼容协议的定义服务商,因此接入 PPIO 不需要修改插件代码。准备好 API Key、接口地址和模型 ID 后,在设置页面完成配置即可。第一步 创建并保存 PPIO API Key
首先注册一个 PPIO 账号,通过专属链接注册还可以获得 ¥50 代金券: https://ppio.com/activity/kilo_code 注册并登录后进入 API 密钥管理页面创建 API Key。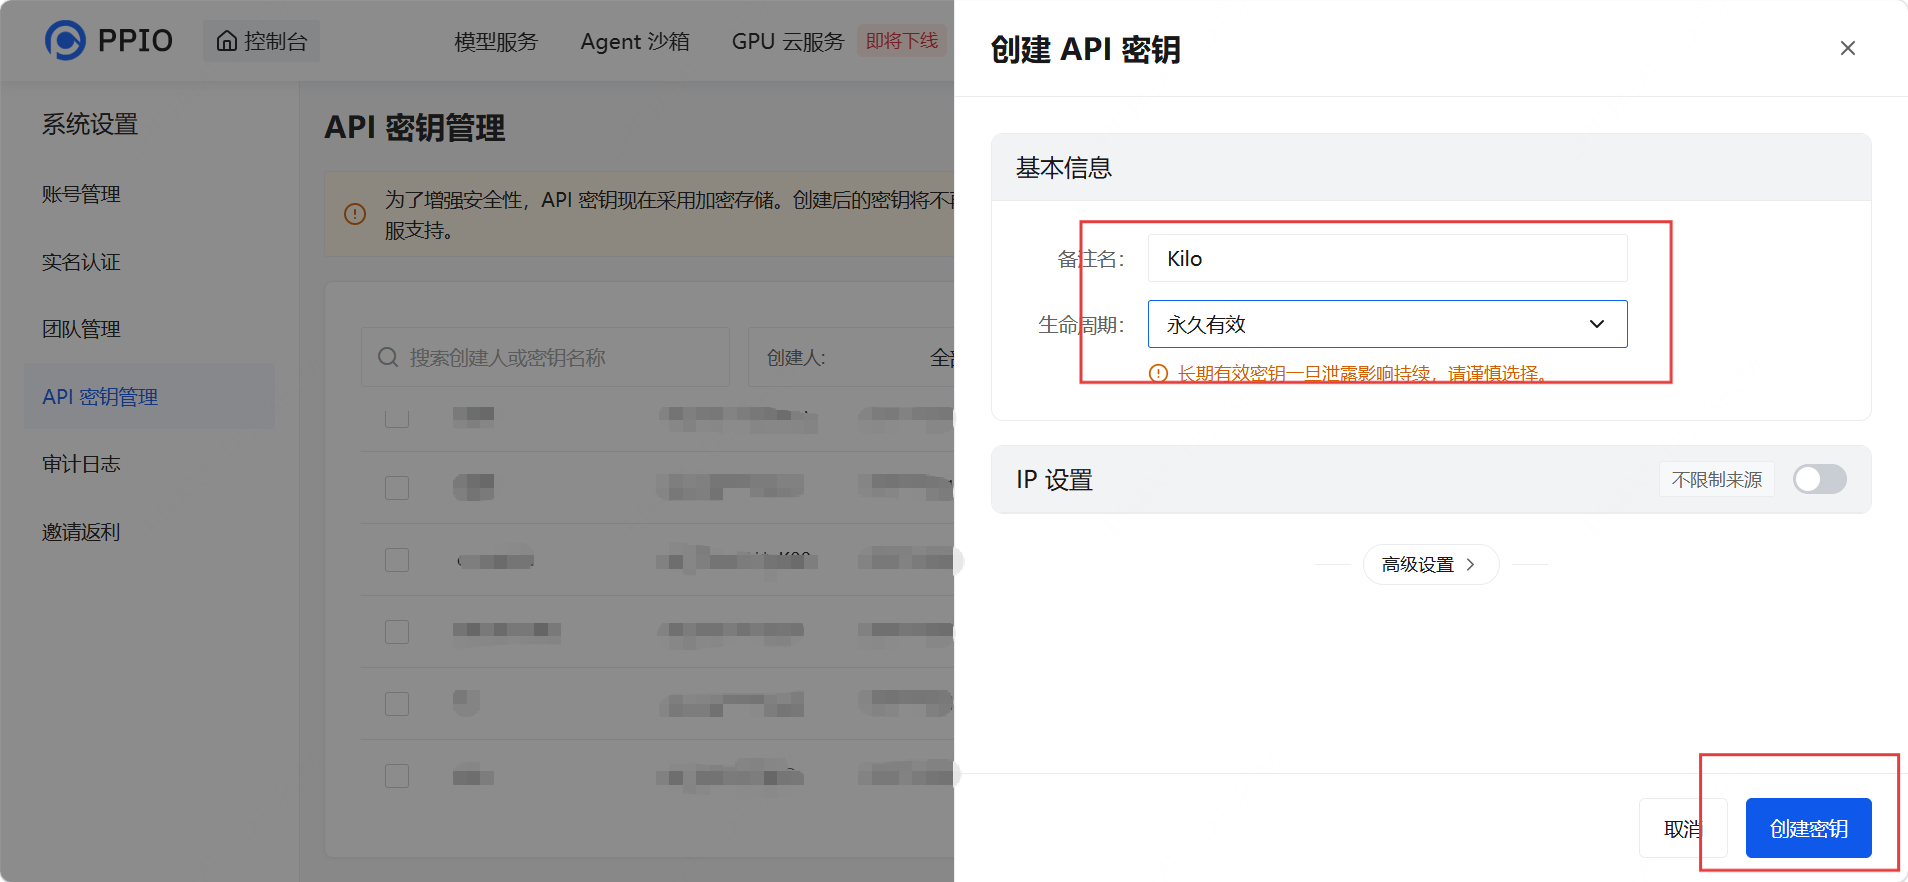
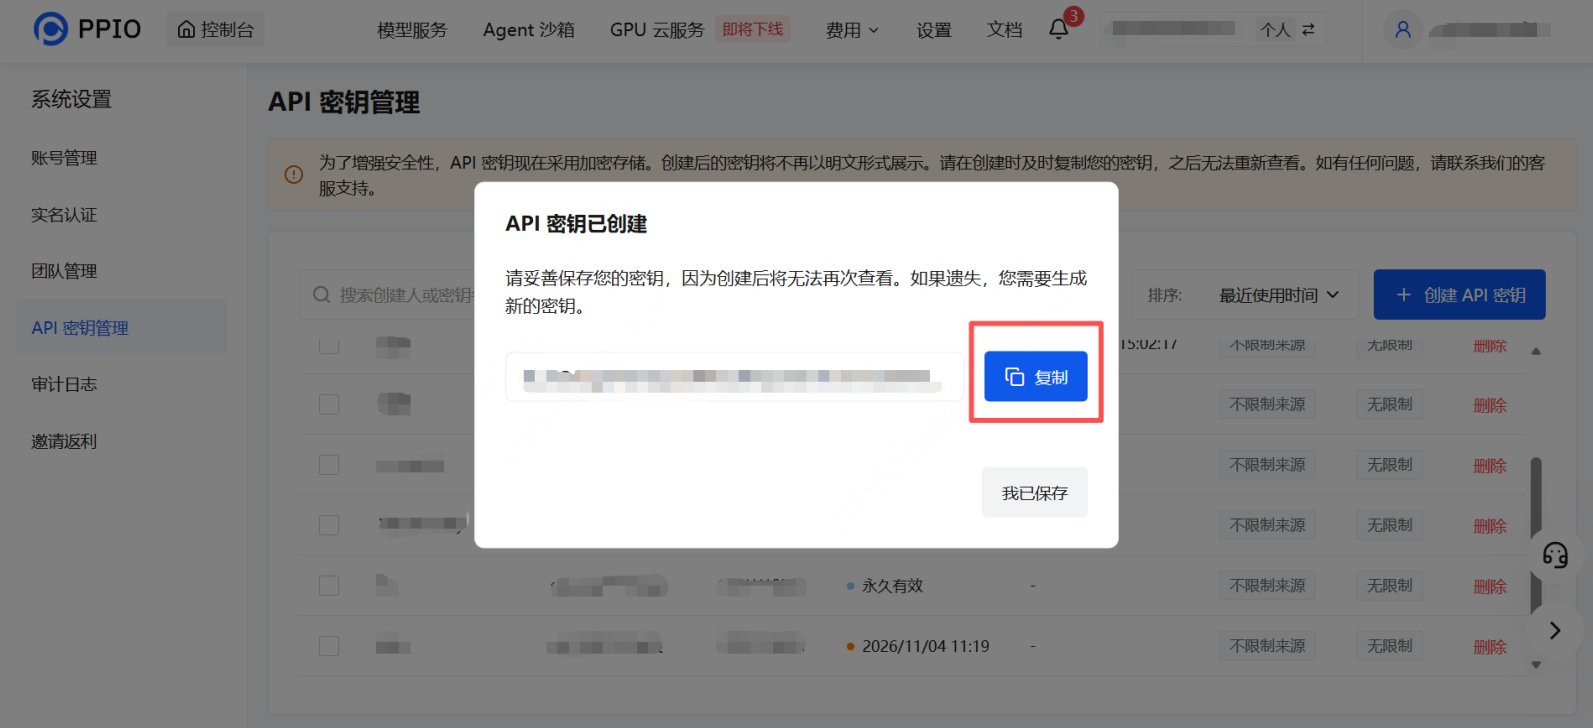
第二步 选择模型并确认接口地址
进入 PPIO 模型广场,选择准备使用的模型,在详情页复制完整的 Base URL 和 Model ID。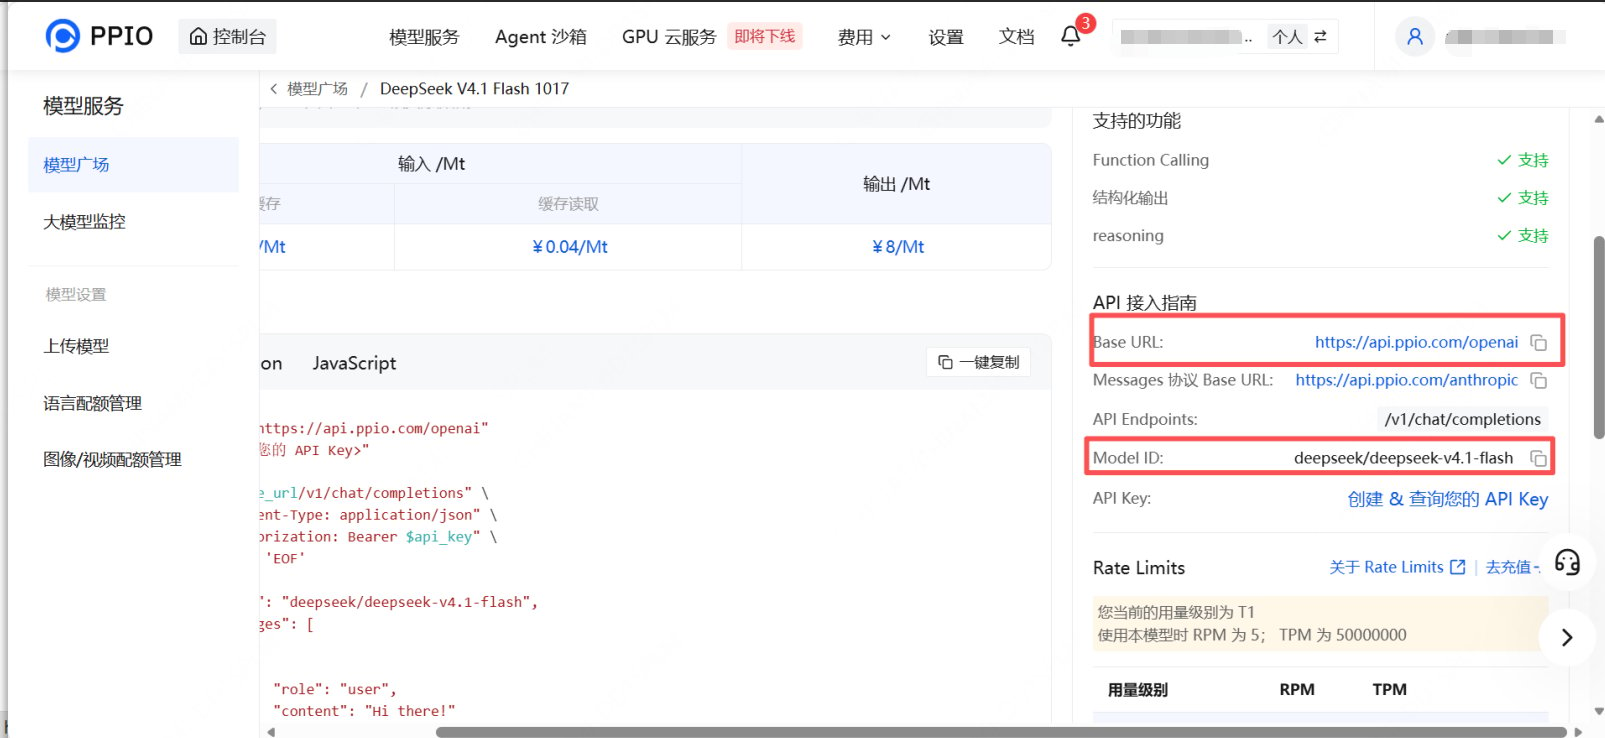
第三步 在 Kilo Code 添加自定义服务商
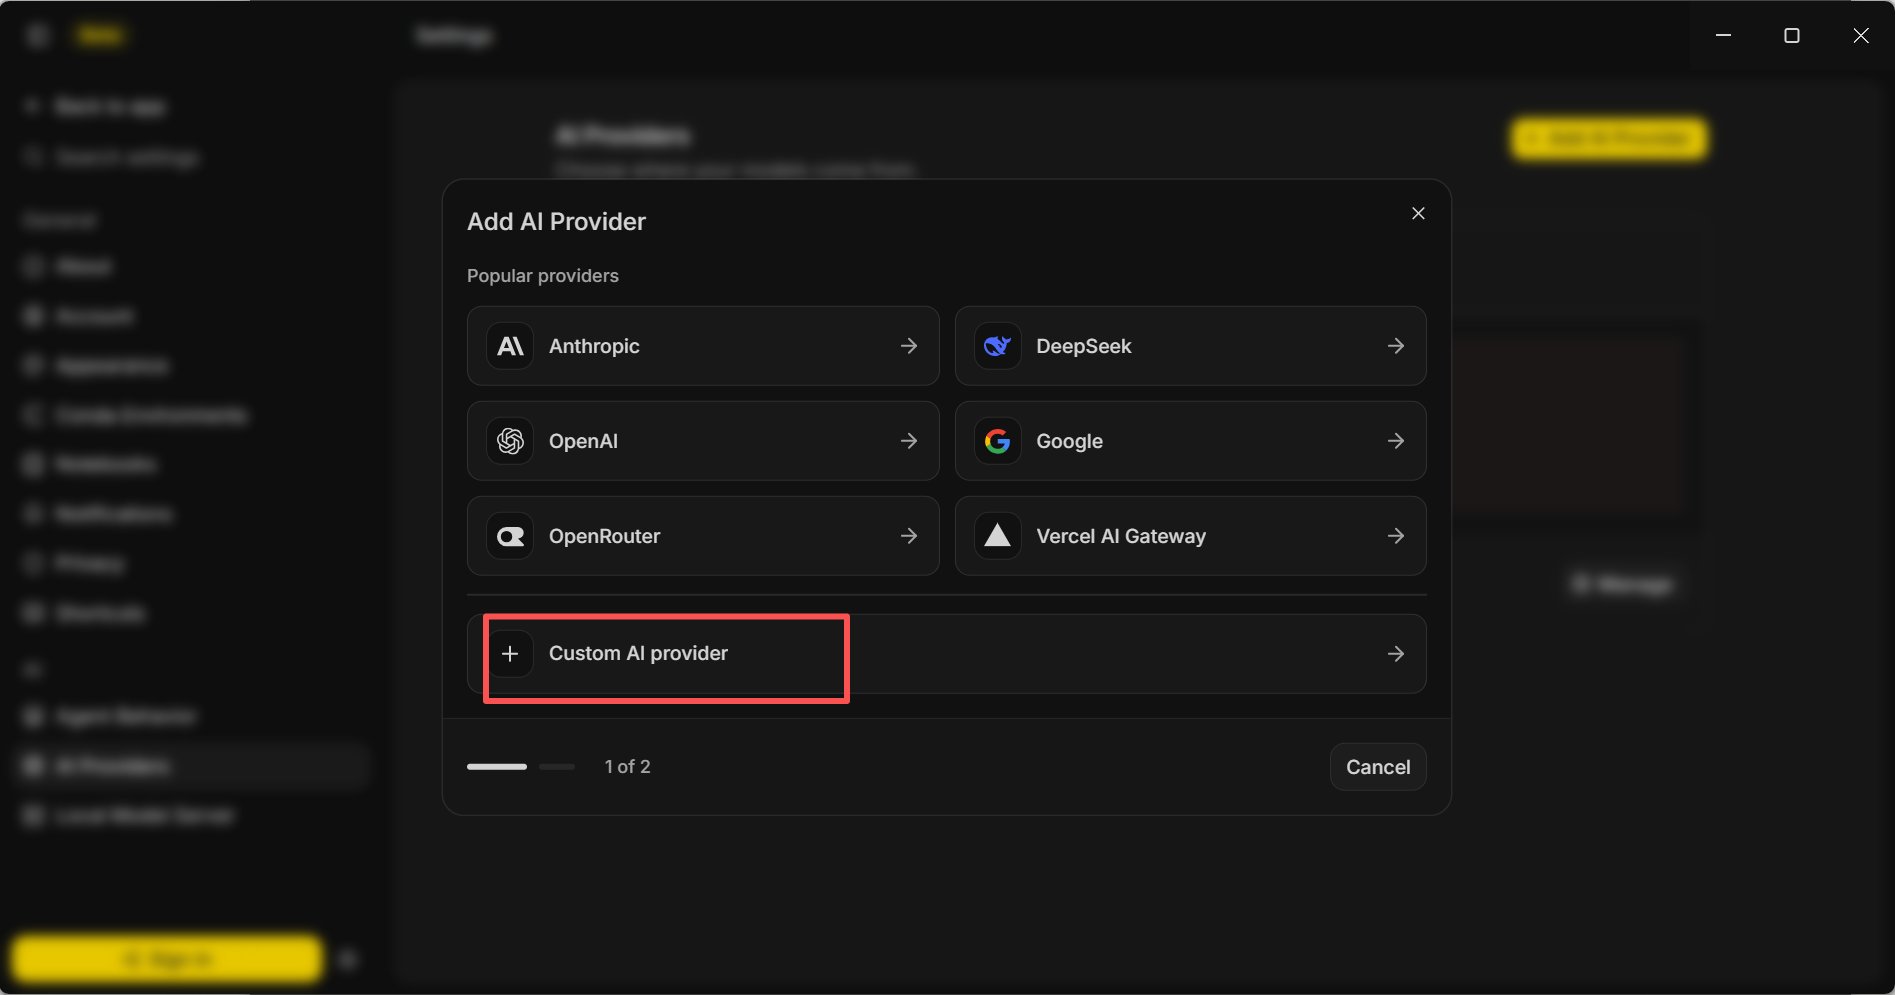
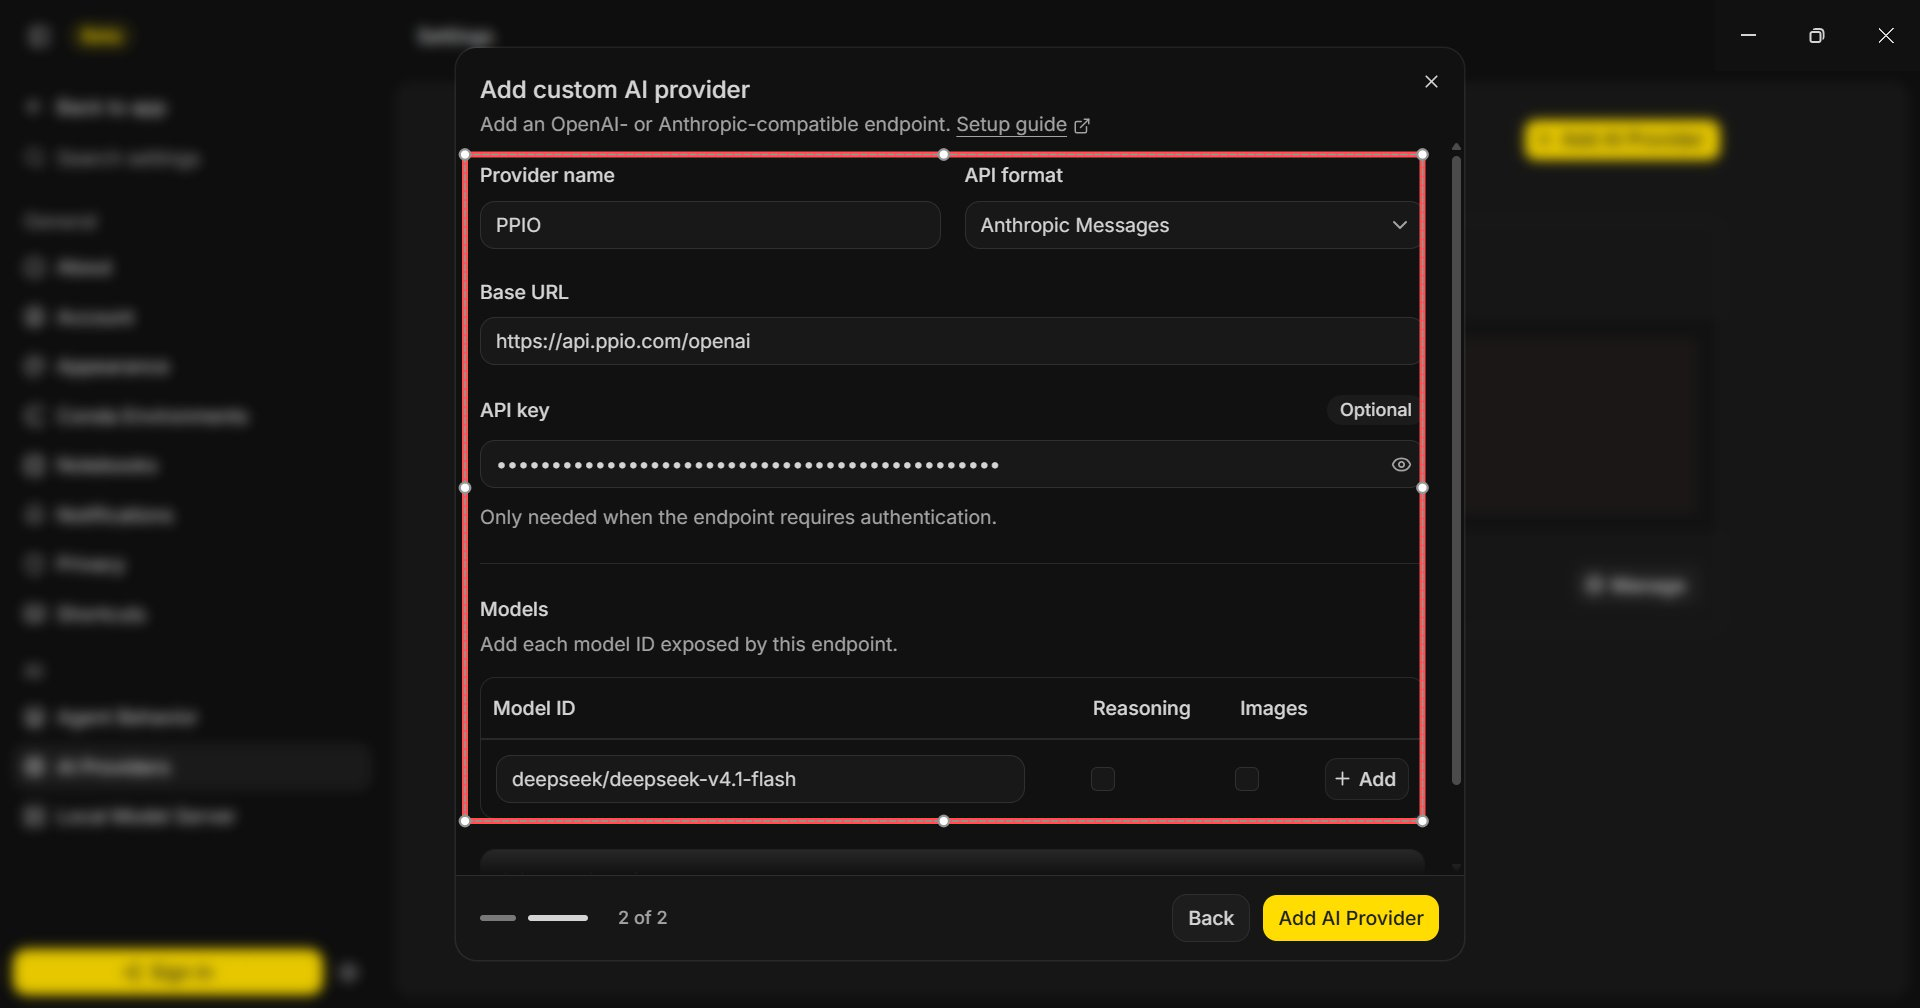
安装 Kilo Code 后,打开设置页面并进入 Providers,滚动到底部,点击 Custom provider,将接口地址(即 Base URL)、API Key 和模型名称(即 Model ID)依次填入即可。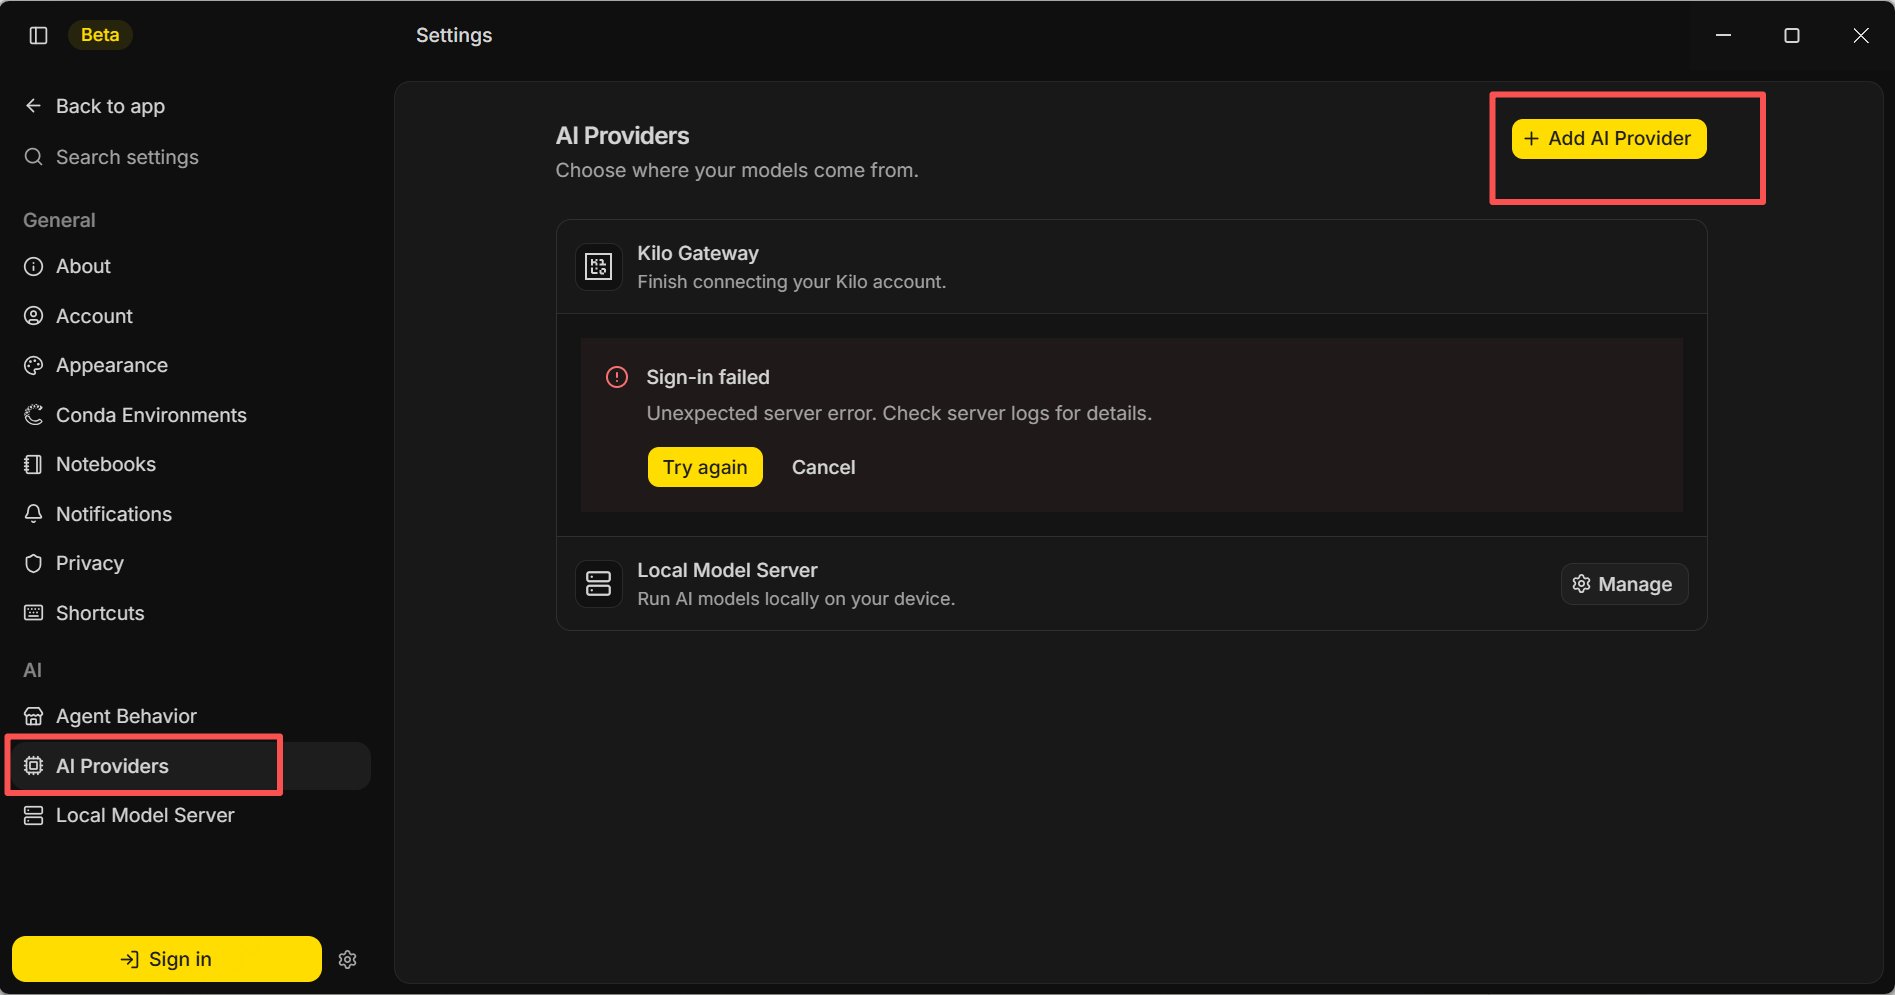
03 订阅 PPIO 企业 Token Plan,旗舰模型低至 6 折
PPIO 企业 Token Plan 是一套标准化的预付费折扣产品,核心机制是“融合 Token”:以 DeepSeek V4 Flash 输入 Token 为基准单位(系数 1.000),其他模型按照各自的抵扣系数折算消耗,共用同一套余额。 PPIO 企业 Token Plan 支持 200+席位,特别适合中小 AI 开发者团队。PPIO Token Plan 搭配 Kilo Code,就是最好的编程协作伙伴。 PPIO 企业 Token Plan 目前覆盖了 17 款模型,包括 DeepSeek V4 Flash 正式版、Kimi K3、GLM-5.2、MiniMax M3 等国产开源旗舰模型在内的全系列模型。后续,新模型上线也将及时同步更新到订阅包中。 PPIO 企业 Token Plan 分三档(见下图),三档基准单价相同,均为 ¥0.95/Mtoken,差异在于 Token 配额、并发上限和服务级别。具体折扣幅度因模型而异 —— DeepSeek 系列约 9 折,Qwen 3.5、GLM-5.2 等官方定价偏高的模型可低至 5~6 折,综合成本节省空间最高接近一半。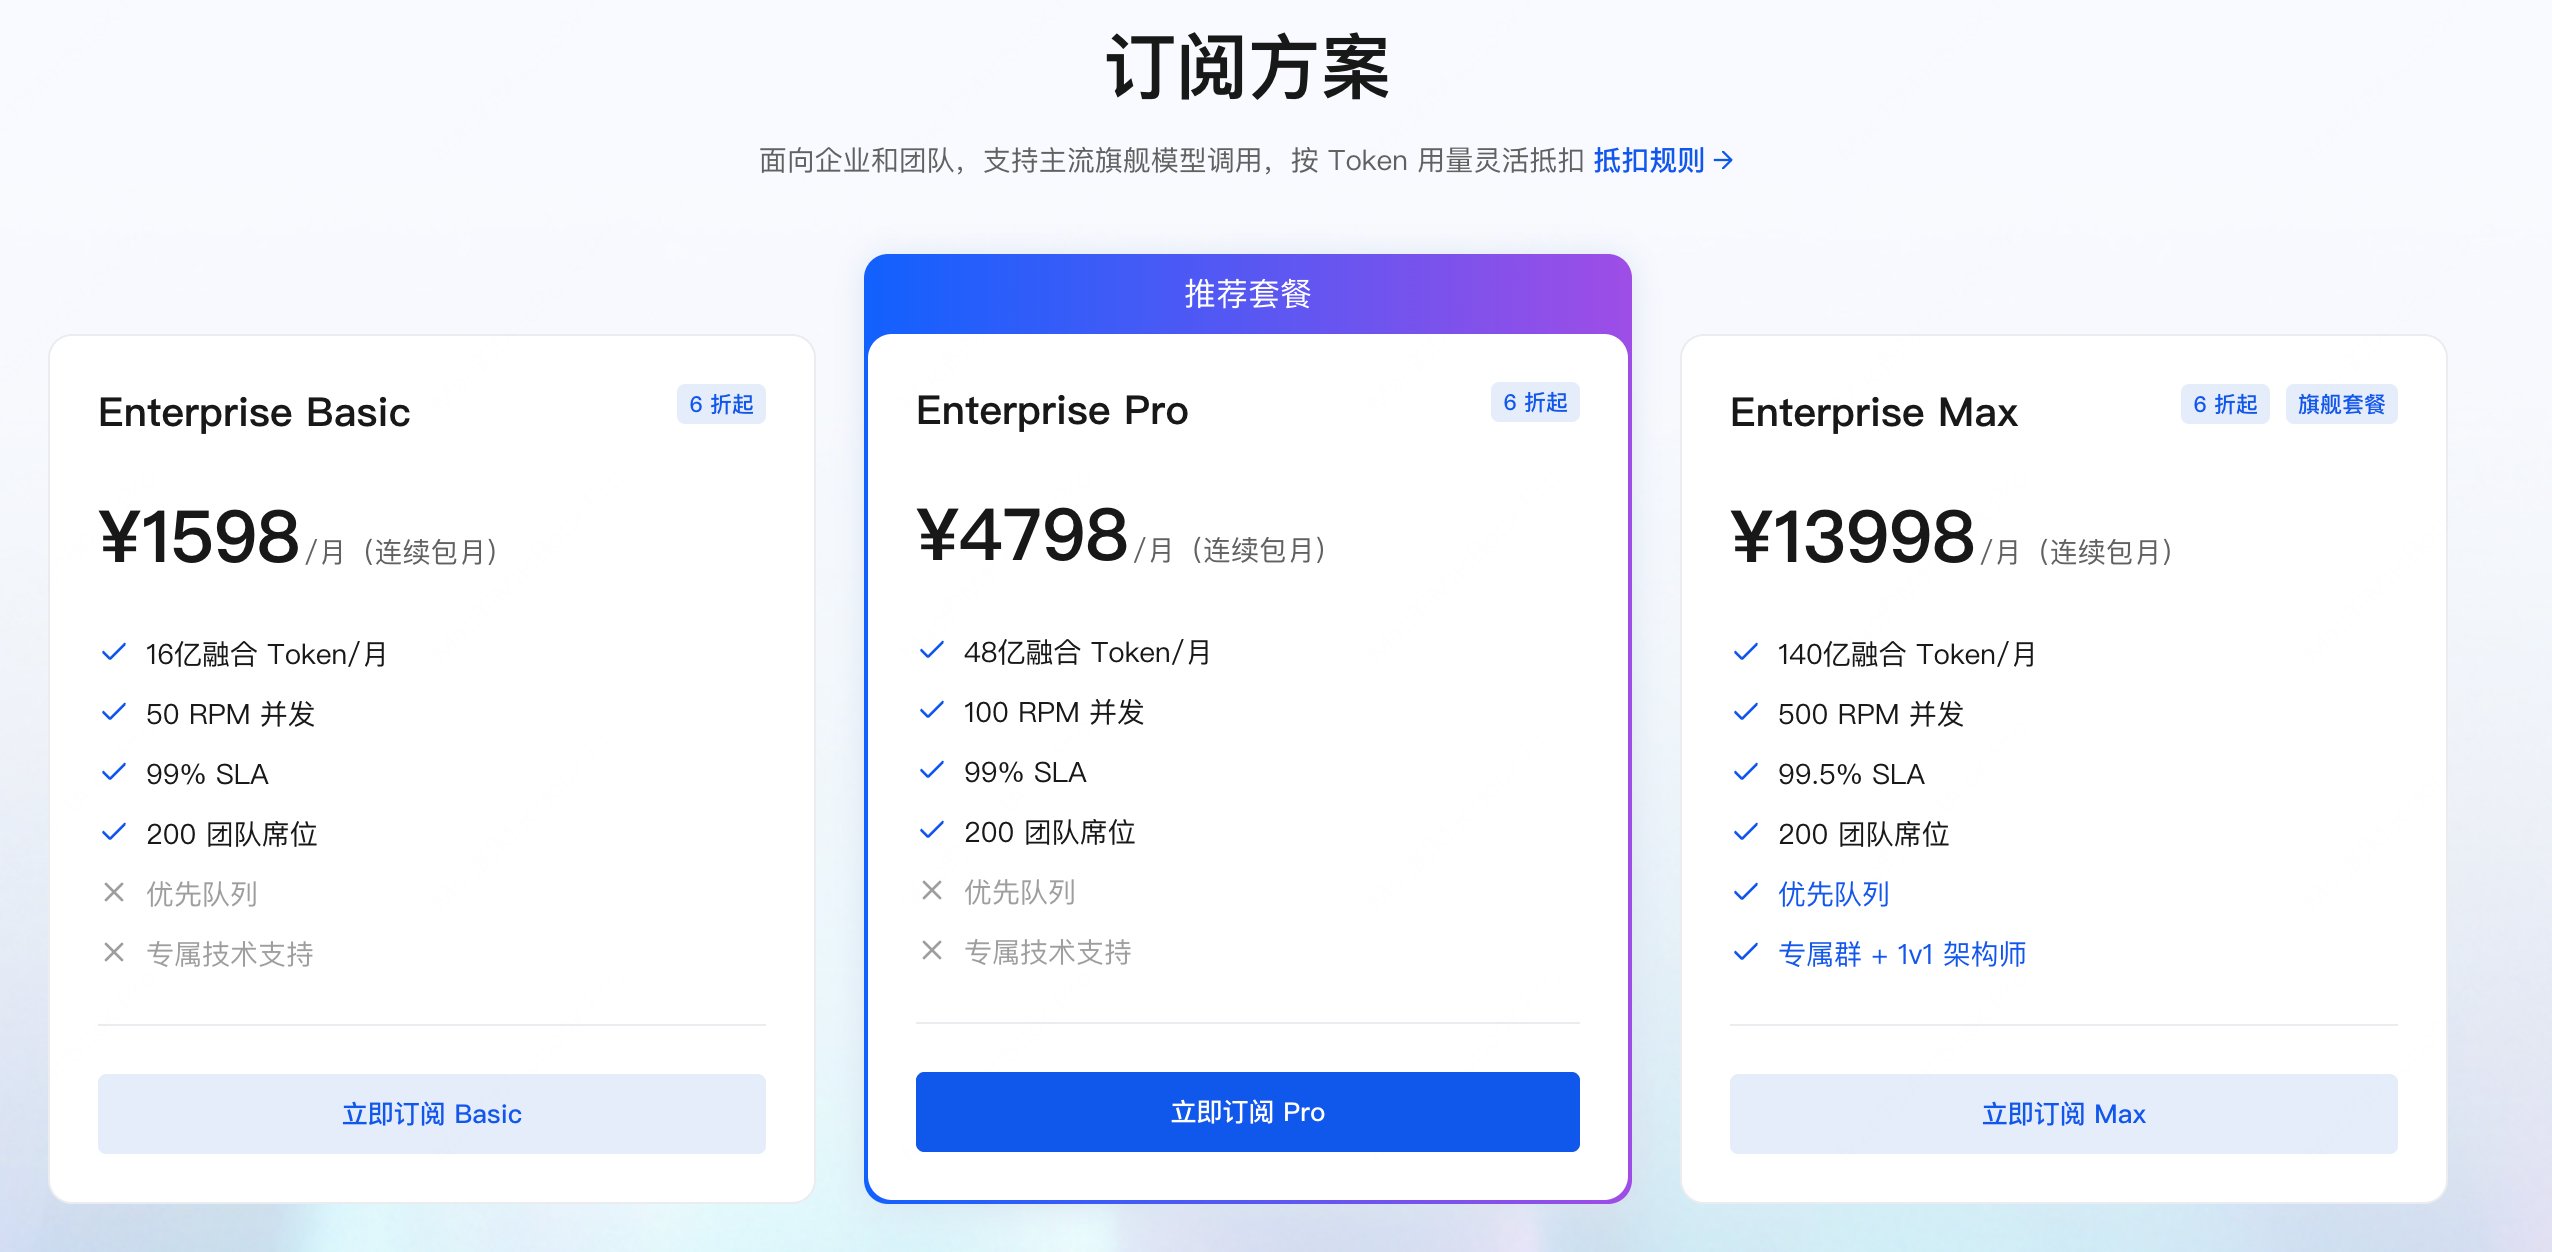
04 Fusion 融合模型已上线,用 1/10 的价格超越顶级模型的智商
除了常规模型之外,PPIO 最新上线的 Fusion 融合模型也已支持接入 Kilo code。 Fusion 融合模型是 PPIO 智能模型网关提供的多模型融合推理能力。调用融合模型时,网关不会只询问一个模型,而是将请求同时分发给多个各需要长的“专家模型”作答,再通过思考编排与交叉验证,由主模型生成最终答案——汇聚模型每次调用都变成一次“专家会诊”。与只做简单请求转发的传统 API 网关不同,融合模型以智能优先、兼顾算计:通过工程化的融合手段,把答案质量稳定放在头部旗舰模型梯队,同时把成本控制在中低梯队。 在 DRACO 深度研究基准测试中,PPIO Fusion 融合模型以 Kimi K3、GLM 5.2、MiniMax M3 为参考模型(Advisors)、DeepSeek V4 Flash 为融合主模型(Aggregator)进行融合推理,超越了 Claude Fable 5,而总成本接近其约 1/10。Fusion 融合模型提供 OpenAI 兼容接口,Base URL 无需改变,只需要将模型名称设置为pprouter/fusion 即可。
Kilo Code 将 AI 从代码问答带进了真实的项目执行流程。接入 PPIO 后,开发者可以根据任务灵活选择模型:日常代码解释和小范围修改使用单模型,遇到跨模块重构、复杂故障排查或关键代码审查时,则可切换至 Fusion,让多个模型共同分析 Kilo Code 提供的项目上下文,无需在多个工具之间反复传递代码和报错信息。
截至 2026 年 9 月,PPIO 日均 Token 调用量达 3.4 万亿,成为国内最大独立“Token 工厂”,为用户持续提供可靠、可扩展、高性价比的模型服务。